Het kiezen van de juiste edge Computing een architectuur voor gedistribueerde locaties vereist zorgvuldige afstemming van technische mogelijkheden, zakelijke doelstellingen en infrastructuurbeperkingen. Naarmate organisaties hun activiteiten uitbreiden naar meerdere locaties, is de vraag naar real-time verwerking, lagere latentie en lokaal beschikbare intelligentie nooit zo groot geweest. Uw keuze voor een architectuur beïnvloedt rechtstreeks de operationele efficiëntie, gegevensbeveiliging en het vermogen om met minimale vertraging te reageren op IoT-gebeurtenissen.
De fundamentele beslissing bij de implementatie van edge computing-oplossingen hangt af van het begrip van waar verwerking moet plaatsvinden: op afgelegen locaties, in regionale hubs of via een hybride model. Deze gids begeleidt u stap voor stap door de cruciale selectiefactoren, van latentievereisten en IoT-sensordichtheid tot netwerkbetrouwbaarheid en benodigde rekenkracht op elke gedistribueerde locatie. Tegen 2026 zullen edge computing-implementatiepatronen waarschijnlijk verschuiven naar geavanceerdere, AI-gestuurde architecturen, wat essentieel maakt om kaders te bouwen die flexibel genoeg zijn om mee te evolueren.
Vertraging is de voornaamste drijfveer achter beslissingen over edge computing voor gedistribueerde locaties. Wanneer IoT-sensoren tijdgevoelige gegevens genereren—zoals bewaking van de gezondheid van machines, videoanalyse of signalen voor autonome besturing—kan zelfs een vertraging van enkele milliseconden de veiligheid, kwaliteit of gebruikerservaring in gevaar brengen. Beoordeel de vertragingsverdraagbaarheid van elke toepassingsworkload: missie-kritieke processen vereisen mogelijk reactietijden van minder dan 100 milliseconden, terwijl analyse en rapportage seconden vertraging kunnen verdragen.
Uw edge computing-architectuur moet gegevens verwerken op de plaats waar ze ontstaan, in plaats van ruwe datastromen naar een centrale cloudfaciliteit te verzenden. Dit vermindert de backhaul-bandbreedte, voorkomt netwerkverdringing en garandeert consistente prestaties, zelfs wanneer de internetconnectiviteit onbetrouwbaar wordt. Documenteer de maximaal aanvaardbare latentie voor de primaire gebruiksscenario’s van elke gedistribueerde locatie, en ontwerp vervolgens de plaatsing van de rekenkracht en de gegevensstromen dienovereenkomstig. Toepassingen die betrekking hebben op real-time IoT-automatisering, voorspellend onderhoud of veiligheidkritieke besluitvorming profiteren doorgaans het meest van lokaal edge-verwerking.
De omvang en het type IoT-apparaten op elke gedistribueerde locatie bepalen de reken- en opslagcapaciteit die uw edge-computingoplossing moet bieden. IoT-omgevingen met hoge dichtheid—zoals productiehalles met honderden sensoren, slimme gebouwsystemen of netwerken voor afstandsmonitoring—genereren continue datastromen die centrale cloudverwerking overweldigen en buitensporige bandbreedte verbruiken. Maak een inventaris van het aantal IoT-sensoren, de gegevensfrequentie en de payloadgrootte per locatie om de basisvereisten voor verwerking vast te stellen.
Houd niet alleen rekening met de huidige sensorbelasting, maar ook met de verwachte groei tot 2026. Organisaties die IoT-functionaliteiten toevoegen of automatisering uitbreiden over meerdere vestigingen, hebben architecturen nodig die soepel mee kunnen schalen. Het vooraf inrichten van edge-computingcapaciteit voor toekomstige IoT-groei voorkomt kostbare herontwerpen en storingen tijdens migraties. Architecturen voor gedistribueerde locaties moeten rekenresources modulair opbouwen, zodat extra verwerkingseenheden naadloos kunnen worden geïntegreerd naarmate de IoT-dichtheid toeneemt.
Drie primaire edge computing-architectuurspatronen dienen gedistribueerde locaties, elk met eigen afwegingen. Een gecentraliseerd edge-model concentreert de rekencapaciteit op een klein aantal regionale hubs, wat de operationele complexiteit en hardwareinvestering verlaagt, maar wel backhaul-latentie en potentiële single-point failures introduceert. Deze aanpak is geschikt voor organisaties met voorspelbare verkeerspatronen en losjes tijdgevoelige werkbelastingen. Omgekeerd plaatst volledig gedistribueerd edge computing de rekencapaciteit op elke afgelegen locatie, wat minimale latentie en maximale veerkracht garandeert, maar de complexiteit van beheer, onderhoud en licentieverlening vermenigvuldigt over tientallen of honderden locaties.
De meest volwassen implementaties maken gebruik van een hybride edge-computingmodel dat de verwerking stratificeert: taakgerichte, latentiegevoelige bewerkingen worden ter plaatse uitgevoerd met lichtgewicht rekenkracht, terwijl resource-intensieve analyses en langetermijnopslag profiteren van regionale of cloudfaciliteiten. Deze evenwichtige aanpak benut de voordelen van edge computing op die plaatsen waar latentie het meest van belang is, terwijl operationele overhead beperkt blijft. Hybride ontwerpen sluiten goed aan bij IoT-workloads die real-time sensorfusie combineren met batchanalyse. Beoordeel uw werklastmix, IT-personeelsbeperkingen en budget om te bepalen waar u uw gedistribueerde locaties het beste kunt plaatsen.
De netwerktopologie bepaalt de prestaties en veerkracht van edge computing in gedistribueerde omgevingen. Als alle edge-computingnodes op afgelegen locaties via één enkele uplink moeten communiceren met een centrale beheershub, loopt u het risico op knelpunten en cascaderende storingen. Implementeer lokaal-netwerkclustering, zodat edge-computingnodes kunnen samenwerken met naburige nodes voordat ze geaggregeerde inzichten naar boven sturen. Dit ontwerp vermindert het benodigde bandbreedtegebruik van de backbone, verbetert storingisolatie en versterkt de veerkracht bij verlies van connectiviteit.
Tegen 2026 zullen edge-computingarchitecturen in toenemende mate meshnetwerken integreren, waarbij gedistribueerde locaties zowel directe peer-to-peerverbindingen onderhouden als uplinks naar de cloud. Mesh-topologieën verdelen de verwerkingsintelligentie over het netwerk en stellen locaties in staat om tijdens uitval van het wide-area network gedeeltelijke autonomie te behouden. Evalueer de geografische verspreiding van uw gedistribueerde locaties, de betrouwbaarheid van hun verbindingen en hun vereisten voor samenwerking tussen locaties bij het kiezen van een topologie. Missie-kritieke of afgelegen locaties profiteren met name van edge-computingimplementaties met meshfunctionaliteit.
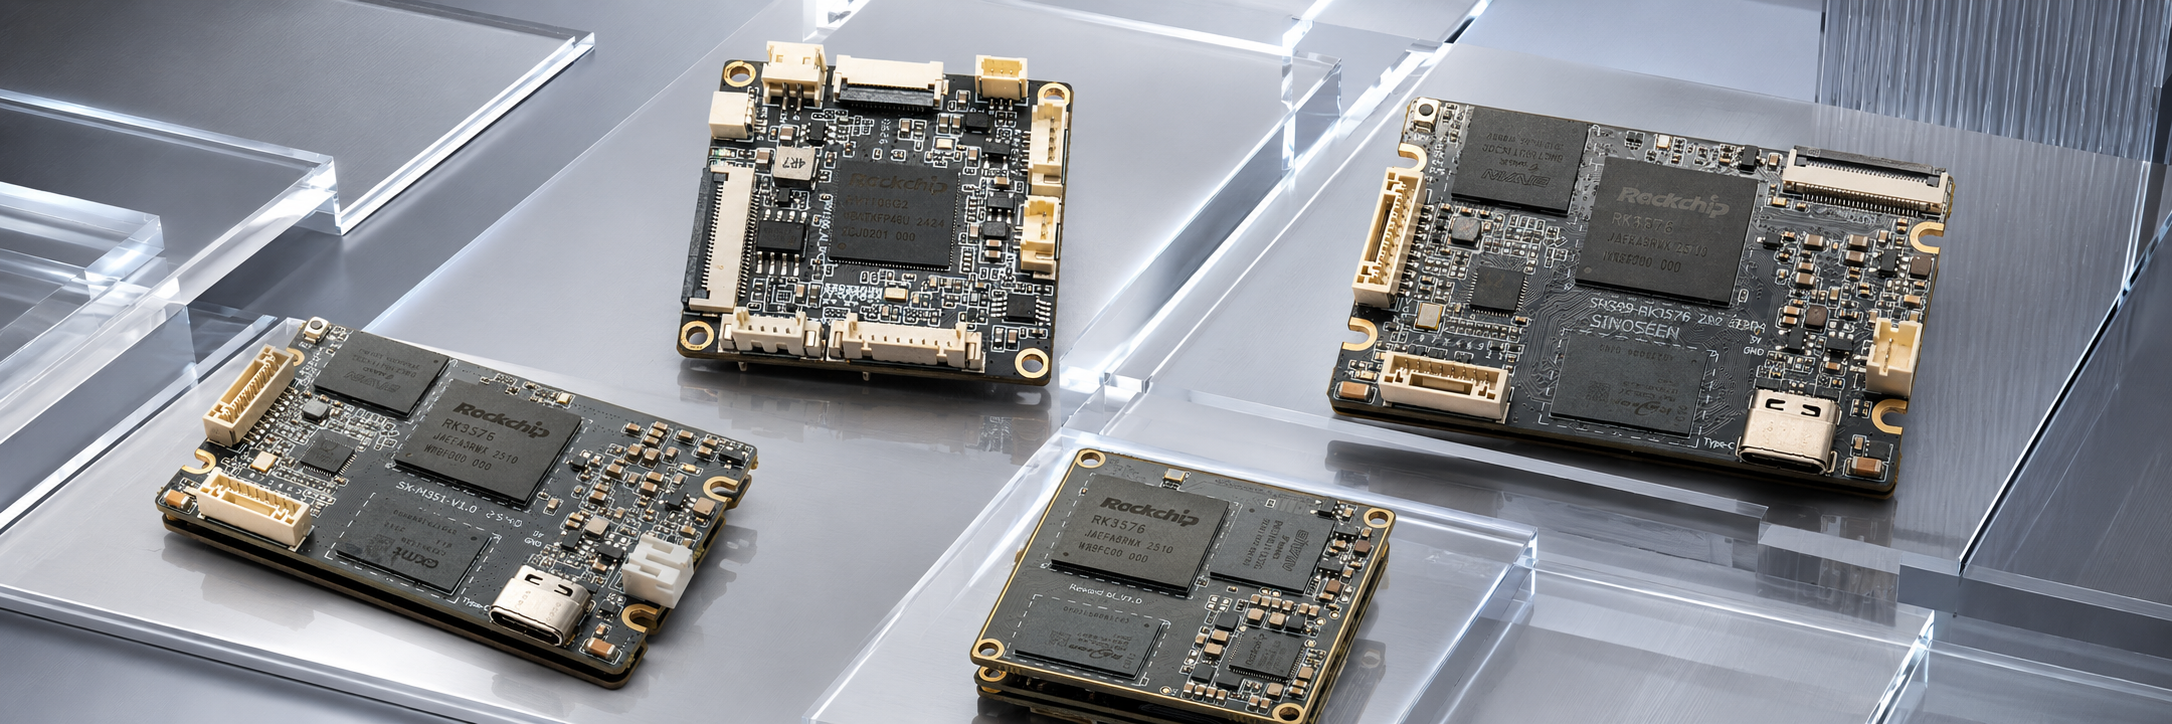
Edge computing-hardware varieert van robuuste IoT-gateways die enkele watt verbruiken tot ventilatorloze industriële pc’s die volledige Kubernetes-clusters uitvoeren. Voor gedistribueerde locaties met matige werkbelastingen bieden edge computing-oplossingen op basis van ARM-processors of compacte x86-boards energie-efficiëntie en thermische eenvoud, wat cruciaal is in uitdagende omgevingen. Voor zware reken- of AI-inferentiewerkbelastingen leveren gerobustiseerde edge computing-servers met discrete GPUs of neurale accelerators de benodigde prestaties. Containerisatie met behulp van Docker en Kubernetes maakt consistente software-implementatie mogelijk over heterogene edge computing-infrastructuur op verschillende locaties, waardoor updates en versiebeheer worden vereenvoudigd.
De keuze van software voor edge computing moet een evenwicht vinden tussen functionaliteitsrijkdom en beperkte bronnen. Lichtgewicht Linux-distributies en minimale container-runtimes behouden verwerkingcapaciteit voor toepassingen. Zoek naar edge-computingplatforms die zowel cloud-native tools als traditionele industriële protocollen ondersteunen, om bestaande IoT-implementaties te verbinden met moderne workloads. Uw edge-computingstrategie voor 2026 dient opkomende AI-frameworks, real-time databases en beveiligingsstandaarden te ondersteunen zonder dat een architectuurherontwerp nodig is.
Gedistribueerde edge-computingsites vergroten uw beveiligingsoppervlak, wat robuuste authenticatie, versleuteling en anomaliedetectie op elk knooppunt vereist. Implementeer certificaatgebaseerde authenticatie voor edge-computingapparaten die communiceren met centrale systemen en dwing cryptografische ondertekening af van software-updates die naar externe locaties worden verspreid. Opslag en verwerking van gevoelige gegevens op edge-computingknooppunten—vooral in industriële IoT-contexten—vereisen zorgvuldige toegangsbeheersing en auditlogging.
Operationele bewaking van edge computing-implementaties op talloze locaties vereist automatisering en intelligentie. Gecentraliseerde dashboards die de gezondheid, prestatiegegevens en latentie van elke gedistribueerde locatie weergeven, maken snelle probleemdetectie mogelijk. Overweeg edge computing-platforms die zero-touch provisioning, automatische apparaatdetectie en push-gebaseerde software-updates bieden om de IT-last ter plaatse tot een minimum te beperken. Tegen 2026 kunt u verwachten dat edge computing-beheertools AI-gestuurde anomaliedetectie en self-healing-functionaliteiten integreren, waardoor grootschalige gedistribueerde implementaties duurzamer worden.
Edge computing bereikt doorgaans latenties van 1–50 milliseconden voor lokaal verwerken, vergeleken met 50–500+ milliseconden voor cloud-roundtrips. De werkelijke latentie hangt af van de afstand tussen uw IoT-sensor en de edge, de complexiteit van de verwerking en de kwaliteit van het netwerk. Goed ontworpen edge-computingarchitecturen voor gedistribueerde locaties minimaliseren variabiliteit en garanderen deterministische reactietijden voor kritieke workloads, waardoor latentie voorspelbaar wordt in plaats van alleen laag.
Het aantal nodes hangt af van de geografische verspreiding, de dichtheid van IoT-apparaten, de redundantievereisten en de gewenste latentie. Een praktische richtlijn: plaats edge computing dicht bij de IoT-gegevensbronnen om het aantal sensor-naar-edge-hops te minimaliseren, en cluster daarna edge-computingnodes regionaal waar connectiviteit en administratieve efficiëntie dit toestaan. Begin met één edge-computingnode per belangrijke locatie of per 50–100 IoT-apparaten, en breid vervolgens uit op basis van gemeten prestaties en beschikbaarheidsdoelen.
Edge computing-normen, AI-versnelling en beveiligingspraktijken ontwikkelen zich snel. Bouw flexibiliteit in uw gedistribueerde site-architectuur door gebruik te maken van containergebaseerde workloads, modulaire hardware en API-first-beheerlagen. Tegen 2026 zullen veel organisaties grote taalmodellen (LLM) en real-time AI-redenering integreren in edge computing-knooppunten; zorg er daarom voor dat uw architectuur software-updates en GPU-versnelling ondersteunt zonder fysieke herontwerp.
 Actueel nieuws
2026-09-21
2026-09-18
2026-09-14
2026-09-13
2026-09-09
2026-09-09

 EN